Эффективное управление ИТ-инцидентами начинается с корректного сочетания программных решений, поддерживающих процесс Incident Management (ITIL), который входит в ITSM (управление ИТ-услугами). Система управления ИТ-инцидентами — это комплекс таких решений: мониторинг обнаруживает сбой, оповещение и эскалация доставляют сигнал ответственному, анализ событий сводит оповещения в инцидент (незапланированное нарушение или снижение качества ИТ-услуги), ITSM-система ведёт его до восстановления сервиса.
Компоненты системы управления ИТ-инцидентами: мониторинг, ITSM, оповещение и эскалация, анализ событий, модель сервисов
Компоненты различаются главной задачей, но многие продукты комбинируют несколько ролей: например, ITSM-системы создают заявки из оповещений, а анализ событий передаёт инцидент во внешние системы. Поэтому в таблице указана главная задача компонента, а не жёсткая граница, и сравнивать правильнее закрываемые функции. Анализ событий выделяют в класс Event Intelligence Solutions (EIS): по Market Guide for Event Intelligence Solutions, это более узкая категория внутри широкого пространства AIOps; подробнее в статье «От AIOps к Event Intelligence Solutions: ребрендинг от Gartner». Не всем организациям нужны все компоненты: набор подбирается под поток событий и зрелость процессов.
| Компонент | Главная задача | Функции |
|---|---|---|
| Системы мониторинга | Обнаружить сбой и сформировать оповещение | Метрики, триггеры, базовые оповещения |
| ITSM-системы и service desk | Учёт обращений и процессов | Тикеты, регламенты, SLA, каталог услуг |
| Оповещение и эскалация (on-call) | Доставить критичное оповещение ответственному специалисту с учётом графика дежурств | Расписание дежурств, каналы уведомлений; если специалист не подтвердил получение, вызов передаётся следующему |
| Модель сервисов и CMDB | Описать связи «бизнес-сервис — ресурс» | Определение, какие ИТ-услуги затронуты сбоем ресурса |
| Анализ событий (класс EIS) | Превратить поток событий в небольшое число инцидентов для разбора | Объединение связанных оповещений, снижение шума, контекст для разбора |
Этапы управления ИТ-инцидентами: какой компонент за какой шаг отвечает
Компоненты образуют цепочку, в которой каждый следующий использует данные предыдущего. Основа цепочки — мониторинг.
- Сигнал. Система мониторинга фиксирует отклонение и формирует оповещение.
- Оповещение и эскалация по графику. Ответственный получает оповещение по графику дежурств; если подтверждения нет, вызов передаётся следующему.
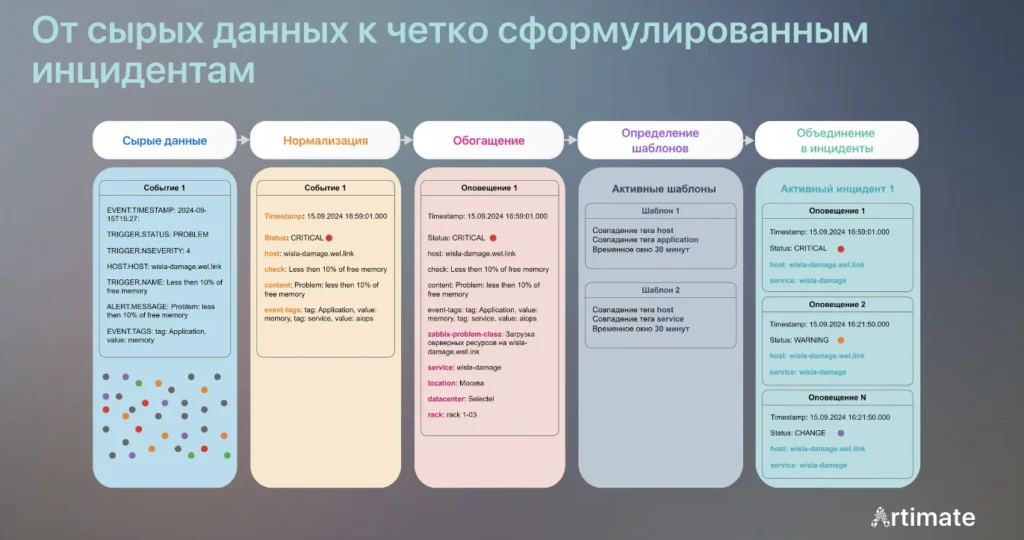
- Сведение в инцидент. Дубликаты устраняются (дедупликация), повторяющиеся события подавляются, связанные оповещения объединяются в карточку инцидента. Эту работу выполняет анализ событий (класс EIS).
- Регистрация и ведение. Инцидент регистрируется в ITSM-системе: назначаются ответственный, приоритет и сроки, оформляются согласования.
- Контекст и причина. История и карта связей между событиями помогают инженеру сформулировать гипотезу о развитии инцидента; причину необходимо проверять по дополнительным данным. Влияние на бизнес-сервисы требует достоверной модели сервисов (CMDB или иной источник связей «бизнес-сервис — ресурс»).
- Решение и разбор. Действия, срок и выводы фиксируются в ITSM-системе.
В рабочем процессе Artimate на вход могут поступать метрики, события, логи, сведения об изменениях и данные топологии. В центре интеграции они проходят нормализацию и обогащение; затем аналитика и AI/ML-компоненты помогают определить подходящие шаблоны и объединить связанные сигналы в активный инцидент. Результаты доступны в консоли платформы и могут передаваться в системы коллаборации и service desk, чаты и по Webhook; управление оповещениями, инцидентами и автоматизацией поддерживает дальнейшую работу команды.
Какие компоненты системы управления ИТ-инцидентами добавить: от текущего состояния процесса
Выбор набора систем начинается с инвентаризации текущих решений и оценки эффективности процесса управления ИТ-инцидентами.
| Что уже есть и в чём затруднение | Что добавить |
|---|---|
| Мониторинга нет или он покрывает не всю инфраструктуру | Мониторинг: остальные компоненты работают с его оповещениями |
| Инциденты записываются в чатах и таблицах, нет единого учёта, сроков и ответственных | ITSM-система или service desk: регистрация инцидентов, ответственные, сроки, история действий |
| Критичные оповещения не всегда доходят до ответственного специалиста, нет понятного графика дежурств | Оповещение и эскалация: доставка ответственному по графику, передача следующему при отсутствии подтверждения |
| Одна авария порождает десятки оповещений, смена не успевает их разбирать | Анализ событий (EIS): объединение связанных оповещений в один инцидент |
| Подключено несколько систем мониторинга, и возникают проблемы с общей картиной | Анализ событий (EIS): сведение событий из разных систем |
| Планируются обучаемые функции (кластеризация, карта связей) | Анализ событий (EIS) с сохранённым архивом |
| Нужно понимать, какой бизнес-сервис затронут сбоем узла | Модель сервисов: CMDB или иной источник, в котором описаны связи «бизнес-сервис — ресурс» |
При небольшом числе событий нередко достаточно пересмотреть пороги и правила в самом мониторинге.
Автоматизация управления ИТ-инцидентами: готовое решение или собственная разработка
После того как определено, каких компонентов не хватает, возникает вопрос: закрывать их готовым продуктом или собственной разработкой, то есть скриптами, правилами маршрутизации и самописной корреляцией оповещений. Для организации с одной системой мониторинга, небольшим потоком событий и собственной командой разработки такой подход оправдан. При нескольких источниках, растущем потоке и требованиях закрытого контура, объяснимости результата и непрерывной поддержки быстро собранный прототип превращается в продукт, который необходимо развивать, обновлять и документировать. Собственная корреляция на правилах реализуема: набор меток и окно времени позволяют объединять повторяющиеся сценарии. Основная сложность связана с постоянным сопровождением:
- правила устаревают при изменении инфраструктуры, и их необходимо регулярно пересматривать;
- обучаемые модели требуют данных, оценки качества и дообучения;
- интерфейс для операторов, ролевую модель, журнал действий и обновления необходимо развивать как продукт;
- уход разработчика решения делает систему непрозрачной для остальной команды.
Разработка собственного решения обоснована при узкой задаче, небольшом числе правил и наличии команды, способной сопровождать систему. Приобретение готового продукта целесообразно при большом числе источников, растущем потоке событий и требовании, чтобы результат был объясним операторам мониторинга, а не только разработчикам.
Место Artimate среди систем управления ИТ-инцидентами
Artimate дополняет действующий мониторинг: собирает события, нормализует, дедуплицирует, обогащает и коррелирует их, формирует инцидент и контекст для первоначального расследования. ITSM остаётся системой учёта и ведения сервисного процесса, когда он организован во внешнем решении.
Платформа собирает данные со всех систем мониторинга, анализирует их в контексте всей инфраструктуры и автоматически объединяет связанные оповещения в единые инциденты.
Передача инцидента во внешние системы. Инцидент передаётся во внешние системы, например, Service Desk и Telegram, через конструктор эскалации и коннекторы к ним.
Источники и установка. Artimate работает как надстройка («зонтик») над системами мониторинга, перечень готовых коннекторов и подключение остальных источников описаны на странице «Коннекторы». Правила работают с первого дня, а обучаемая часть (кластеризация, карта связей) использует историю событий.
Для оценки платформы на собственных данных заявку на демо можно оставить на странице центра управления инцидентами.
Эффективное управление ИТ-инцидентами строится из компонентов, которые закрывают цепочку от сигнала до разбора: мониторинга, оповещения и эскалации, анализа событий, ITSM-системы и модели сервисов. Основа цепочки — мониторинг; остальные компоненты добавляются там, где процесс затруднён. Выбор начинается с обязательных условий и оценки текущего состояния процесса.